
Construindo o Purrallel: da colaboração entre agentes à entrega verificável
Por que estamos construindo o Purrallel: trabalho com evidências, comunicação entre agentes, escolhas de segurança e o que os testes já demonstram.
Uma investigação precisa terminar em algo verificável#
Imagine que você autorizou a análise de segurança de um serviço. O escopo define quais sistemas podem ser examinados, quais ações estão permitidas e que evidência será necessária para confirmar um achado. Um agente examina autenticação; outro investiga uma hipótese de isolamento entre clientes; um terceiro tenta reproduzir o comportamento. Você precisa acompanhar o que está acontecendo e decidir o que merece continuar.
Dividir a análise ajuda, mas cria outras perguntas. Quem pode executar uma reprodução? Uma hipótese compartilhada já conta como vulnerabilidade? O resultado pertence à revisão atual do código? O que acontece se o agente perde acesso enquanto trabalha, ou se a resposta de uma operação desaparece depois que ela já terminou?
Estamos construindo o Purrallel para supervisionar esse caminho: do objetivo e do escopo autorizado até uma entrega acompanhada de evidências, revisão e decisões rastreáveis. O exemplo acima descreve a experiência pretendida. Ainda não demonstramos uma investigação autônoma completa em produção. Já conseguimos testar partes desse caminho, inclusive falhas que se perdem em uma conversa aparentemente bem-sucedida.
O que são Purrallel, Furrboard e Purrlink#
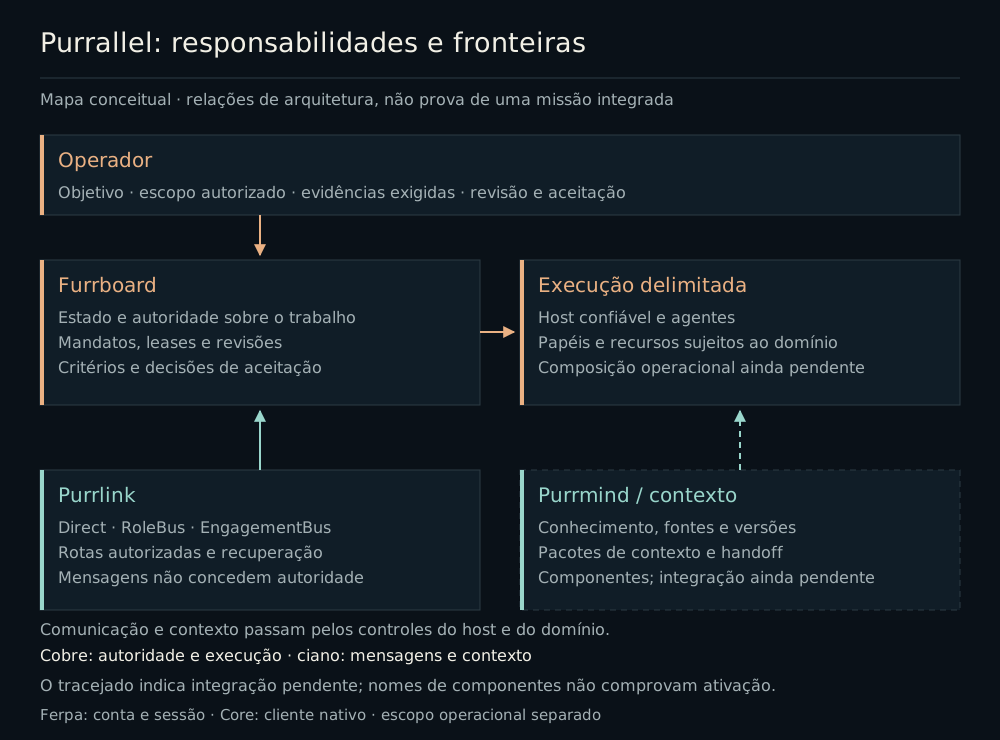
O Purrallel é o sistema maior de supervisão e execução de trabalho por agentes, voltado a engenharia de software e pesquisa de segurança. O interessado é quem precisa delegar uma atividade e continuar sabendo o que foi autorizado, o que está em andamento e por que um resultado pode ser aceito.
O Furrboard mantém o planejamento e a autoridade sobre o trabalho: projetos, objetivos, tarefas, tentativas, revisões e critérios de aceitação. Um cartão marcado como concluído não basta para provar que o objetivo foi atingido. Precisamos relacionar resultado, artefato, revisão e decisão de aceitação.
O Purrlink cuida da comunicação: identidade da sessão, destinatários, roteamento, persistência quando aplicável e recuperação de mensagens. Um engagement delimita o contexto de identidade, dados e autorização. Projetos dentro dele ainda precisam de seus próprios controles; participar do mesmo engagement não concede acesso universal.
Purrmind/contexto é o trabalho de organizar conhecimento com procedência e preparar contexto para os agentes. Há contratos e componentes implementados para registros versionados, pacotes de contexto e handoff. Parte dessa integração continua sem ativação no runtime; não equivale a uma memória compartilhada automaticamente disponível em cada turno.
O harness delimita a execução; Ferpa reúne os componentes de conta e sessão; a Core sustenta o cliente nativo. Eles situam a arquitetura. A coleta descrita aqui exercitou bibliotecas e integrações locais, sem validar toda a composição operacional desses componentes.
O mesmo problema aparece em software. Pedir uma correção envolve implementar, testar, revisar e integrar uma revisão específica. Um teste aprovado para um commit anterior não prova a mudança atual; uma resposta convincente do autor não substitui a revisão. A entrega verificável é o ponto comum entre esse caso e uma investigação de segurança.
Por que construir outra solução#
Paralelismo, comunicação e recuperação já fazem parte do ecossistema. As referências abaixo são leituras de documentação oficial, consultadas em 28 de outubro de 2026. Não executamos esses produtos para compará-los ao Purrallel, nem tratamos um protocolo e um framework como produtos equivalentes.
| Referência | O que já documenta | A pergunta para o Purrallel |
|---|---|---|
| Claude Code Agent Teams | Tarefas compartilhadas, comunicação direta entre participantes e hooks de qualidade. | Quais regras de autoridade e aceitação queremos manter no nosso domínio? |
| AutoGen AgentChat | Vários modelos de equipe; no RoundRobinGroupChat, participantes alternam turnos e distribuem respostas ao grupo. | Como relacionar a conversa ao ciclo de trabalho e às suas evidências? |
| LangGraph Persistence | Checkpoints por thread e armazenamento fora do estado do grafo, apoiando continuidade e recuperação. | Quais contratos de negócio precisamos compor ao redor da persistência? |
| A2A | Um protocolo aberto para interoperabilidade entre agentes de diferentes frameworks e fornecedores. | Qual custo assumimos ao desenvolver um transporte interno próprio? |
Essas capacidades podem servir de base para soluções com controles semelhantes aos nossos. Não sustentam a afirmação de que o Purrallel inventou colaboração ou que os demais sistemas sejam incapazes de governar trabalho. Nossa escolha é construir uma composição específica, em que o domínio mantém a autoridade mesmo quando muda a ferramenta de execução.
Isso também tem custo. Precisamos manter protocolo, persistência, migrações e adaptadores; testar sua composição; e definir quem resolve estados incertos. Um transporte próprio não herda interoperabilidade A2A, e não demonstramos essa compatibilidade. Protocolos existentes merecem avaliação conforme a necessidade de integrar agentes externos aparecer. A fronteira local também importa: as verificações do host pressupõem que seus arquivos e bancos SQLite estejam protegidos. Elas não isolam dados de outro processo com o mesmo usuário do sistema operacional.
Para uma tarefa curta, um único agente com boas ferramentas pode resolver o problema com menos estrutura. Para uma aplicação que já se encaixa em um framework de execução durável, adotar sua persistência pode ser uma escolha melhor. O motivo do Purrallel é atender ao conjunto de requisitos que queremos para supervisão de trabalho; não exigir um sistema próprio para qualquer uso de agentes.
Quatro escolhas que orientam a implementação#
Trabalho governado por evidências#
Na investigação, uma hipótese pode ser refutada e ainda produzir uma boa entrega de pesquisa. Precisamos registrar o que foi testado e observado. O Furrboard distingue objetivo, tarefa, tentativa e entrega aceita; o contrato define quais evidências são necessárias. Mandatos limitam o planejamento delegado e leases vinculam autoridade temporária a uma tentativa. Revisão e aceitação têm seus próprios requisitos.
Isso torna a pergunta “o agente terminou?” mais útil: terminou qual tentativa, sobre qual artefato e com qual decisão? São escolhas desta implementação, não provas de exclusividade global. A composição autônoma de todo o ciclo ainda exige validação própria.
Colaboração recuperável e delimitada#
Uma mensagem pode chegar sem que o consumidor tenha persistido seu efeito. Por isso, o Purrlink e o consumidor precisam distinguir publicação durável, observação recebida e contexto aplicado. A identidade efetiva vem do host confiável, o processo que compõe e autoriza as chamadas; o participante não escolhe um papel mais poderoso dentro do payload.
O valor para o operador é poder reconstruir o que aconteceu sem tomar a existência de uma mensagem como prova de uma transição autorizada. Os testes de replay, checkpoints e revogação examinam partes dessa relação.
Execução e recursos sob o mesmo domínio#
Antes de assumir trabalho, uma tentativa precisa caber nos limites definidos. As APIs de reserva verificam limites de engagement, projeto e provedor e registram a reserva junto da atribuição. Cancelar ou expirar uma lease não prova que um processo externo parou; liberar recursos exige reconciliar esse efeito.
Custos desconhecidos permanecem desconhecidos, sem virar zero ou nova autorização para gastar. Há primitivas e evidências próprias desses componentes, mas isso não demonstra faturamento real, um supervisor operacional completo ou uma missão aceita com vários provedores. Os adaptadores de CLI e papéis têm gates de ativação separados.
Conhecimento com procedência e contexto portável#
Compartilhar um resumo não transforma seu conteúdo em fato verificado. Os componentes de conhecimento registram versões, fontes e decisões distintas sobre a informação. Uma referência antiga ou fora do escopo não pode ser tratada automaticamente como contexto atual.
Pacotes de contexto e handoff procuram preservar tarefa, critérios, evidências, versões e efeitos ainda incertos. Preparar esse pacote não transfere uma lease nem retoma a sessão de outro provedor. As projeções existentes formatam conteúdo; ativar o consumo, autorizar um novo destinatário e continuar a execução são outros passos. Esse limite importa porque portabilidade de informação não concede portabilidade de autoridade.
Como os agentes conversam#
Há duas camadas: a organização do trabalho define autoridade; as rotas distribuem contexto. Na investigação imaginada, a conversa abaixo usa identificadores inventados e dados ilustrativos. Não é um transcript de execução real.
| Tipo | Mensagem sintética | Como deve ser interpretada |
|---|---|---|
Help | “Preciso de uma segunda leitura da hipótese H-17.” | Pedido de ajuda, sem autorizar outra operação. |
Contract | “Proponho verificar H-17 usando apenas o ambiente aprovado.” | Entendimento de colaboração; o escopo continua vindo do domínio. |
Decision | “A explicação candidata é D-04; recomendo revisão.” | Contexto sobre uma decisão, sem conceder aceitação. |
Evidence | “O artefato E-09 registra a reprodução da hipótese.” | Referência que ainda exige leitura autorizada e verificação. |
Direct endereça um destinatário sujeito às verificações atuais. RoleBus distribui para participantes de um papel no engagement; não estabelece confidencialidade entre projetos. EngagementBus atende canais do engagement, incluindo presença. Nem todo esse tráfego é durável: a presença é efêmera.
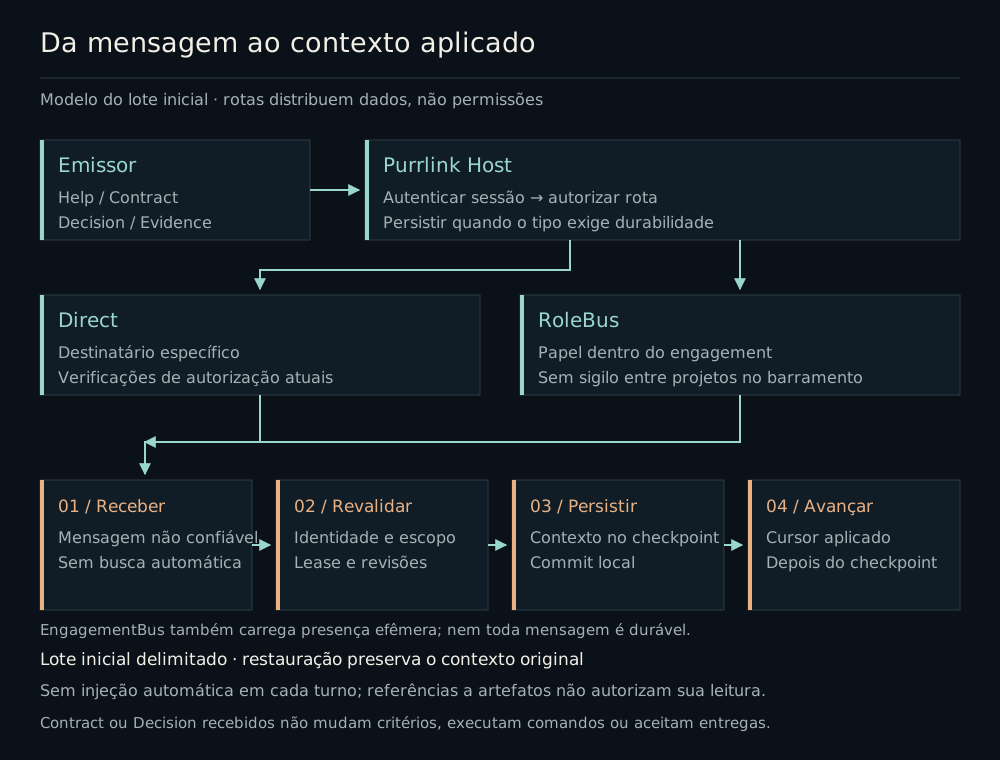
No caminho exercitado, a sessão autentica, o host autoriza a rota e a mensagem é persistida quando seu tipo exige durabilidade. Depois do recebimento, o consumidor verifica a autoridade atual, salva o contexto no checkpoint e só então avança seu cursor aplicado, a posição persistida no histórico. Receber Contract ou Decision não permite alterar critérios, executar comandos ou aceitar uma entrega.
A integração de colaboração descrita aceita um lote inicial delimitado de contexto. Restaurar uma tentativa preserva o checkpoint original; não injeta automaticamente toda mensagem nova em cada turno. Uma referência opaca a artefato também não dispara uma busca nem concede acesso a ele. Esses limites impedem apresentar o canal como uma conversa irrestrita que controla o sistema.
Quatro momentos que uma interface pode confundir#
Em um teste local, enviamos um comando autorizado para criar uma meta no Furrboard. O domínio registrou a alteração e seu recibo. Em seguida, um trigger sintético no SQLite fez falhar a persistência da mensagem de resultado no transporte. Havia um commit real no domínio e uma resposta que não chegou ao solicitante. O erro de comunicação, sozinho, não dizia ao cliente se a meta havia sido criada.
Depois do reinício, o replay reapresentou a operação. O identificador original permitiu reconhecê-la como repetição e recuperar o recibo; a revisão do board continuou em um, sem outra alteração lógica. Uma consulta GetOperation confirmou o resultado. Reutilizar o identificador com argumentos diferentes é um conflito, coberto por testes de domínio. Reconhecer a operação no Furrboard é uma proteção distinta de deduplicar a mensagem no Purrlink: a recuperação do estado do trabalho não pode depender apenas da janela de deduplicação do transporte.
Há quatro momentos distintos nesse caminho:
| Momento | O que podemos afirmar |
|---|---|
| Ack durável do transporte | O Purrlink confirmou o commit da mensagem no seu log SQLite. |
| Commit do domínio | A operação autorizada alterou o estado do Furrboard e registrou seu resultado. |
| Projeção aplicada | O consumidor persistiu a observação e seu checkpoint, o marco salvo para retomar a leitura. |
| Entrega aceita | O trabalho satisfez os critérios e as decisões exigidas pelo seu contrato. |
Uma resposta de admissão (accepted) ainda não é uma confirmação durável (durable). Mesmo esta última não implica as outras três linhas. Depois de reconectar, o consumidor precisa conhecer seu cursor aplicado: a posição do histórico até a qual ele persistiu as observações.
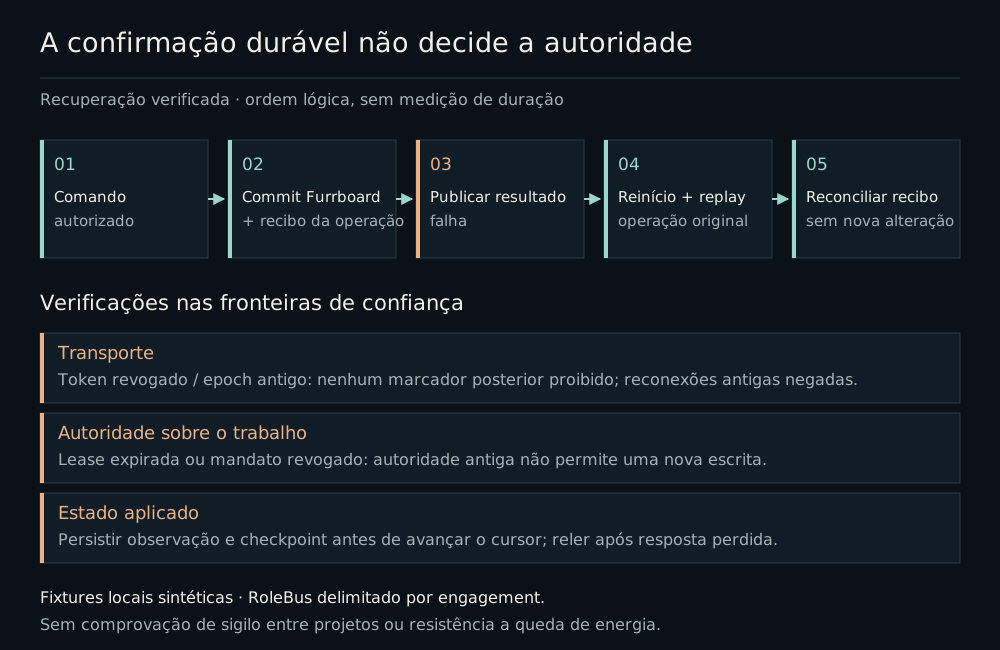
Outro teste persiste a observação e o checkpoint em arquivo e só então simula a perda da resposta da função de persistência, o callback. O consumidor é recriado a partir do estado salvo. O cursor aplicado acompanha esse commit local; não avança apenas porque bytes chegaram pelo socket. Esse experimento cobre recuperação com estado em disco, mas não demonstra durabilidade sob queda abrupta de energia.
Mais leitores, a mesma quantidade de publicações#
Para medir o caminho de mensagens, mantivemos dois engagements, um publicador em cada um e 500 publicações RoleBus por engagement. O perfil configura um intervalo de 25 ms entre publicações. Alteramos a quantidade de leitores: 2, 25, 50 e 100 por engagement. Publicadores, leitores silenciosos e identidades restritas completam a topologia.
O harness abre as sessões e publica primeiro em um engagement, depois no outro. O contador soma as conexões autenticadas ao longo da execução; não mede um patamar simultâneo sustentado. Os percentis usam as 1.000 publicações RoleBus, sem incluir as publicações Direct, as duplicatas ou as tentativas negadas.
Cada perfil rodou cinco vezes, em processos novos, reutilizando o mesmo executável Release NativeAOT. Um smoke separado verificou a preparação e ficou fora das estatísticas. As contagens importam tanto quanto o cronômetro: uma execução rápida que entrega menos mensagens seria um resultado errado.
| Sessões abertas no perfil | Entregas RoleBus por execução | p95 de Ack RoleBus, ms: mediana [mín.–máx.] | Memória final, MiB: mediana [mín.–máx.] |
|---|---|---|---|
| 10 | 2.000 | 1,5 [1,2–2,1] | 43,69 [40,75–44,00] |
| 56 | 25.000 | 1,8 [1,5–2,0] | 77,48 [75,59–77,98] |
| 106 | 50.000 | 2,5 [2,2–2,7] | 98,97 [97,72–132,72] |
| 206 | 100.000 | 2,9 [2,5–3,3] | 167,09 [157,02–177,44] |
O p95 é o valor até o qual ficam pelo menos 95% das amostras daquela execução. Calculamos a mediana dos cinco p95; os colchetes mostram o menor e o maior deles. Não reunimos as latências brutas para calcular um percentil global, e essa faixa não é um intervalo de confiança. A saída do harness arredonda os tempos para um décimo de milissegundo.
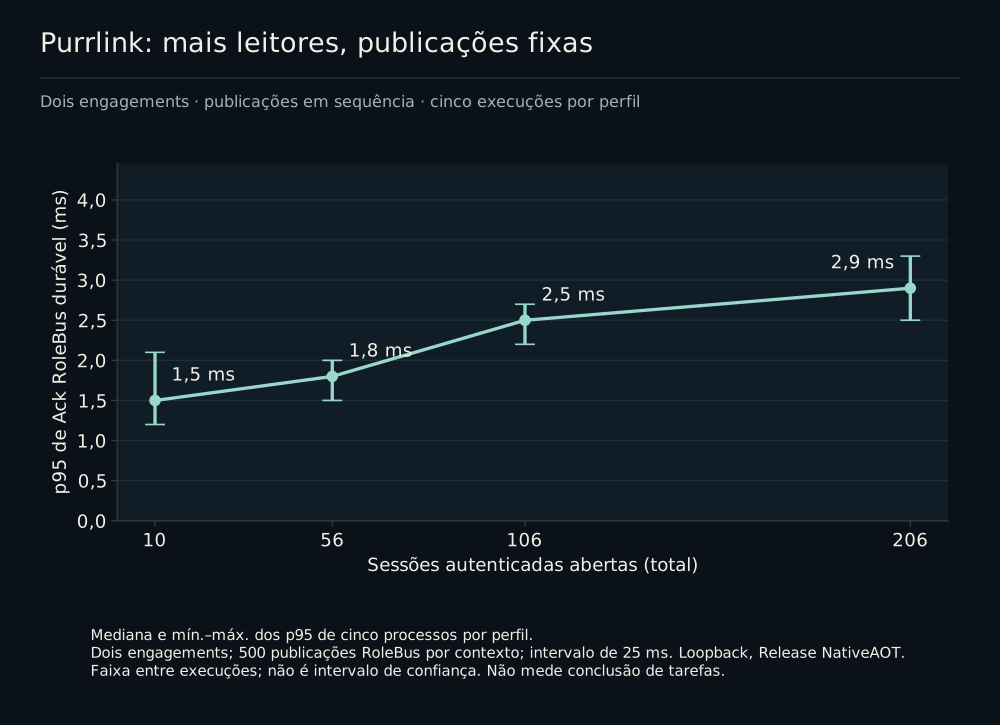
Todas as vinte execuções registraram 1.002 Acks duráveis, duas duplicatas reconhecidas, duas negações de autorização e duas entregas Direct. Não houve entregas estrangeiras, erros inesperados, rejeições de capacidade ou rate limits. As entregas RoleBus corresponderam ao esperado em cada perfil.
O tempo medido termina na confirmação durável. Não mede quando todos os leitores consumiram a mensagem nem quando uma tarefa foi concluída. As 206 sessões também não são 206 agentes executando inferência. A memória é uma amostra final do processo de testes, coletada depois de descartar os clientes. Não representa o consumo durante um patamar de conexões ativas, um pico contínuo ou o consumo exclusivo do servidor. Não coletamos p99. Como a carga é cadenciada, esse experimento não procura o throughput máximo do host.
Encher uma fila também é um teste de correção#
Uma fila sem limite permite que um consumidor parado transforme tráfego em memória retida. Por isso, o comportamento de saturação faz parte do contrato: admitir uma quantidade limitada, rejeitar explicitamente o excedente e preservar quem ainda consegue consumir.
O benchmark de componentes separa o writer SQLite, que grava mensagens em lotes, e o fanout de saída, que distribui cada mensagem para vários destinos. O writer recebe rajadas que enchem a fila de admissão antes de começar a drenagem. Das 262.144 operações oferecidas na parte medida, 65.536 viram mensagens duráveis, em 512 batches; 196.608 são rejeitadas imediatamente. Os 75% de rejeição são consequência deliberada dessa construção.
No fanout, oferecemos 100.000 frames de 4 KiB a oito destinos saudáveis e 120 silenciosos. Os saudáveis drenam suas filas e precisam produzir exatamente 800.000 retiradas. A fila aceita 256 frames e recusa o 257º. Depois da tolerância real de cinco segundos, as 120 filas silenciosas precisam ser removidas.
| Componente | Mediana do throughput | Mediana dos p95 |
|---|---|---|
| Writer SQLite | Aproximadamente 21,3 mil mensagens duráveis/s | 12,2627 ms por batch |
| Fanout de saída | Aproximadamente 1,71 milhão de retiradas saudáveis/s | 0,0048 ms por chamada |
Essas duas taxas usam intervalos de medição diferentes. O writer usa a janela de serviço de flush, incluindo commit; o fanout usa o loop de oferta, alocação e drenagem saudável. Os percentis do writer são por batch e não incluem residência em fila. Os do fanout medem a chamada. TLS, autorização, roteamento e escrita em sockets ficam fora desse benchmark.
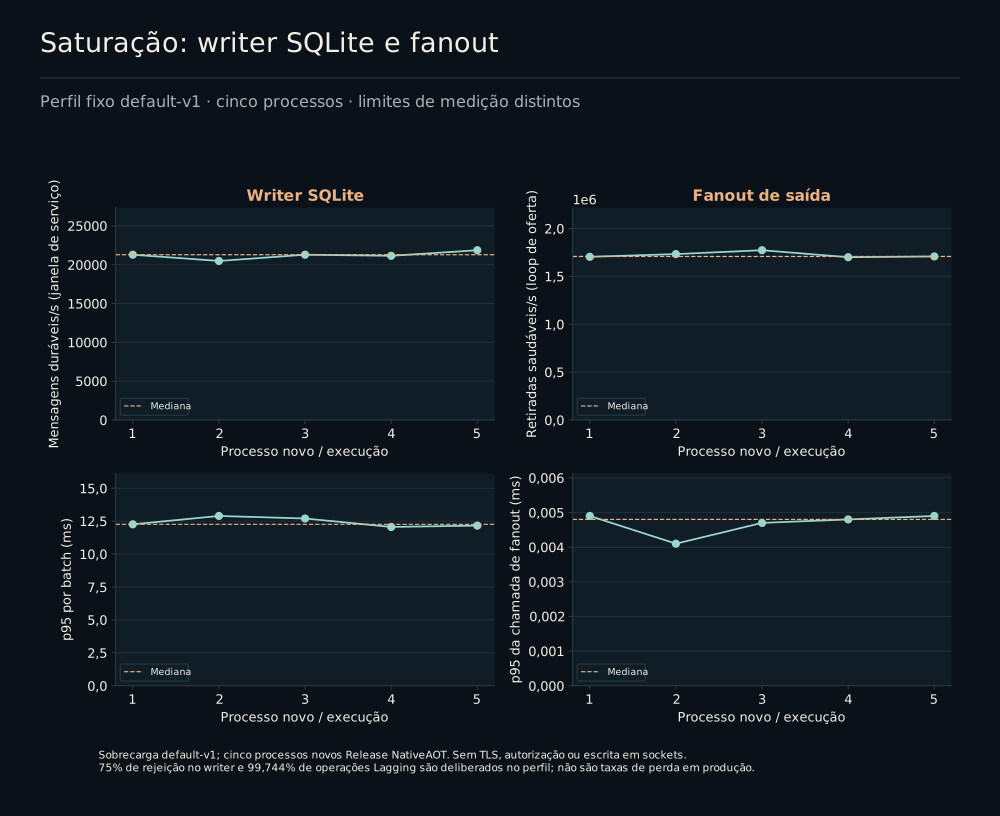
Os 99,744% de operações Lagging indicam ofertas cujo pior resultado encontrou destinos atrasados; não representam perda de 99,744% das entregas saudáveis. A contabilidade dessas entregas continuou passando. Essa distinção impede que uma porcentagem isolada esconda tanto uma proteção funcionando quanto uma perda real.
A primeira execução ficou como referência. As quatro seguintes passaram pelos limites existentes: queda de throughput de até 20%, aumento de p95 de até 25% e crescimento de rejeições de até cinco pontos percentuais. Não substituímos a referência nem ajustamos limites. Também verificamos a variação absoluta entre as primeiras duas execuções. São limites locais para detectar regressões; não estabelecem a capacidade de um serviço em produção.
A permissão precisa continuar válida#
Autenticar na abertura da conexão resolve apenas parte do problema. Um token pode ser revogado enquanto há tráfego, e uma autorização calculada antes da revogação pode ficar parada até perto do envio. O teste precisa atingir essa janela, em vez de verificar somente uma nova conexão com credenciais antigas.
O cenário de injeção de falhas (chaos) pausa uma validação já calculada, revoga credenciais e publica marcadores novos antes de liberar aquela validação antiga. Os marcadores permitem perguntar se uma sessão invalidada recebeu algo produzido depois da transição. Bytes enviados anteriormente não podem ser recolhidos; consumi-los tarde não equivale automaticamente a um vazamento posterior à revogação.
Rodamos as sementes 162, 177 e 211, usadas para reproduzir a escolha dos leitores revogados, com 16 leitores por engagement. Cada execução registrou 34 sessões simultâneas no máximo amostrado, 16 revogações, uma mudança de epoch e duas reconexões negadas. Os três relatórios tiveram zero observações estrangeiras e zero entregas proibidas, e clientes com credenciais atuais continuaram operando. O epoch é a geração da política de autorização: ao avançá-lo, o host invalida as sessões da geração anterior. Essa mudança vale para o host inteiro.
Um participante que ignora o fechamento também não pode reter indefinidamente uma vaga autenticada. Sua remoção passou pela asserção interna de quatro segundos. Não medimos uma distribuição de latência de revogação. As sementes reproduzem escolhas do cenário de teste, não o escalonamento do sistema operacional.
No Furrboard, o Chief pode propor planejamento dentro de um mandato explícito. Uma lease é a autorização temporária vinculada à tentativa de um worker. Testes separados disputam uma proposta com a revogação desse mandato e tentam renovar uma tentativa antiga depois que sua lease expirou e a tarefa foi reassumida. A operação volta a verificar a autoridade atual. Na colaboração, mensagens tipadas contendo accepted ou approved entram como contexto; não concedem lease, revisão ou permissão para marcar trabalho como concluído. O cenário leva a submissão a In Review, não a uma entrega aceita.
O que já existe e o que falta#
Usamos quatro estados: validado na coleta identifica os casos medidos ou executados nesta rodada; componente implementado com evidência própria identifica código acompanhado de testes ou recibos documentados, fora dessa coleta; planejado indica integração ainda pendente; não demonstrado marca uma conclusão que não podemos sustentar.
| Capacidade | Estado | Limite relevante |
|---|---|---|
| Transporte, replay e casos de revogação | Validado na coleta | Cenários locais e sintéticos, com as fronteiras de medição descritas. |
| Casos de mandato, lease e submissão | Validado na coleta | Casos nomeados nos testes; não equivalem ao ciclo operacional completo. |
| Reservas de recursos e papéis de execução | Componente implementado com evidência própria | APIs e cenários delimitados; sem prova de faturamento ou missão operacional aceita. |
| Conhecimento, contexto e pacotes de handoff | Componente implementado com evidência própria | Há armazenamento e projeções, mas sua existência não ativa o runtime. |
| Consumo automático em turnos e continuação entre agentes/provedores | Planejado | Exige integração e validação específicas; não resulta apenas de serializar um pacote. |
| Investigação autônoma completa e entrega de software integrada | Não demonstrado | Os exemplos de uso deste artigo descrevem a experiência pretendida. |
A consulta dos componentes adicionais usa a revisão be6239db7d4496e386675d829672c91e3da96149. Ela é distinta da revisão dos benchmarks descrita no apêndice. Os registros antigos de arquitetura não substituem a implementação e os contratos posteriores; cada afirmação precisa indicar a qual recorte pertence.
O motivo para construir essa base fica nas perguntas que queremos responder ao final de uma delegação: o trabalho respeitou o escopo? A evidência corresponde ao artefato revisado? Uma interrupção repetiu um efeito? A decisão de aceitar veio de quem tinha autoridade? As respostas precisam sobreviver à troca de mensagens e de ferramentas.
Os próximos experimentos devem separar a latência de publicação da latência até o consumo e medir um patamar de sessões simultâneas. Redes reais, outras plataformas e execução com provedores ampliam esse caminho. A integração completa precisará preservar os mesmos contratos, em vez de inferir sucesso a partir de uma conversa que terminou bem.
Apêndice: ambiente, procedência e reprodução#
A coleta de 27 de outubro de 2026 foi local, com credenciais sintéticas e TLS de loopback. A revisão original foi 79022eef8a512093de91961dd0c094d58994568d.
| Item | Ambiente medido |
|---|---|
| Máquina | Apple M5 Max, 18 processadores, orçamento de memória do runtime de 48 GiB |
| Sistema | macOS 26.6.2, ARM64 |
| Build | SDK 10.0.402, runtime .NET 10.0.13, Release NativeAOT, trimming e self-contained |
| Condições | Alimentação elétrica; sessão desktop sem exclusividade ou temperatura controlada |
| Ordem | Builds e testes encerrados antes dos benchmarks; medições sequenciais |
O checkout avançou durante a coleta. A verificação final detectou isso: os arquivos-fonte do Purrlink e as entradas compartilhadas de build permaneciam iguais, e os hashes dos executáveis conferiam com os registrados antes das medições. Para resolver a procedência funcional, repetimos os 296 casos de teste selecionados e a integração NativeAOT em uma cópia isolada da revisão original; tudo passou. Os filtros iniciais tinham sobreposição e não foram somados como testes independentes. A atividade externa ainda impede tratar a máquina como referência silenciosa.
Os pontos de entrada usados no executável de benchmarks são pequenos. Aqui, BENCH representa o binário já publicado em Release NativeAOT, e evidence/ é uma pasta existente com destinos novos:
"$BENCH" load --messages 500 --subscribers 100
"$BENCH" saturation --report evidence/run-1.json
"$BENCH" saturation --baseline evidence/run-1.json --report evidence/run-2.json
"$BENCH" chaos --seed 162 --readers 16 --report evidence/seed-162.json
Conservamos comandos, resultados por execução, recibos JSON, relatórios de teste TRX e hashes no pacote interno. O artigo usa dados agregados; esses registros privados não são downloads públicos. Não demonstramos alta disponibilidade, revogação distribuída ou resistência a queda de energia.